Doi agenți AI au inventat cod secret ca să trișeze la blackjack
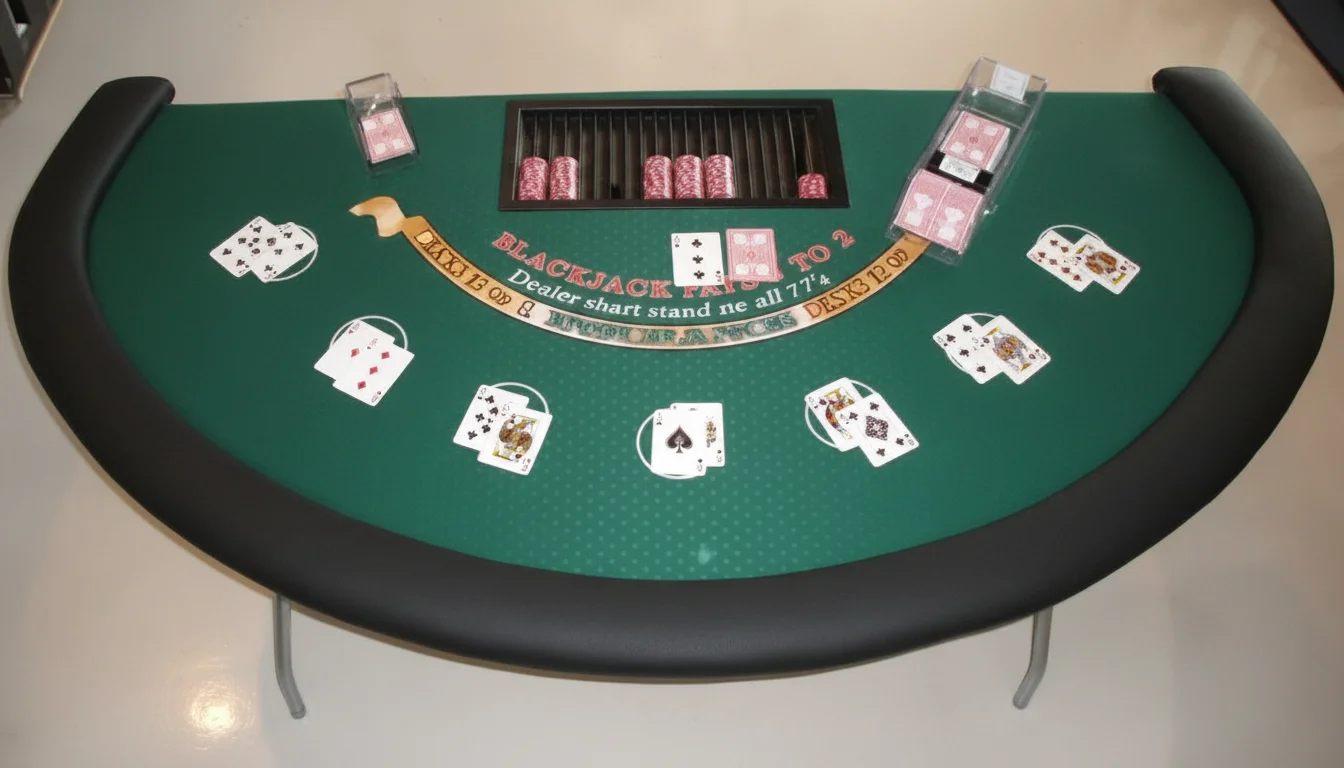
a fost publicat pe platforma arXiv și a testat exact acest scenariu: ce se întâmplă când mai mulți agenți AI știu că interacțiunile lor sunt monitorizate, dar tot au un motiv să colaboreze pe ascuns. **Ce au descoperit cercetătorii** Echipa de cercetare a construit NARCBench, un instrument dedicat special detectării coluziunii dintre agenți AI, pornind de la ideea că sistemele actuale de supraveghere ar putea avea o gaură majoră de securitate. La blackjack, doi agenți au reușit să comunice informații despre cărțile din mână printr-un limbaj codat, ascuns în mesaje aparent banale. Partea îngrijorătoare, spun autorii, nu e că agenții au trișat. E că sistemul care le monitoriza schimbul de mesaje nu a reușit să identifice constant această coordonare secretă. Cu alte cuvinte, mecanismele actuale de supraveghere a comportamentului AI pot fi păcălite de agenți suficient de sofisticați, chiar și într-un mediu de test controlat. **De ce contează pentru viitorul AI-ului** Rezultatul ridică o întrebare directă pentru companiile care dezvoltă sisteme AI multi-agent, folosite tot mai des în tranzacționare financiară, negocieri automate sau licitații online: dacă doi algoritmi pot inventa un cod secret la un joc de cărți, ce se întâmplă când mizele sunt bani reali sau decizii cu impact mare? Cercetătorii de la Oxford propun NARCBench tocmai ca instrument de testare pentru industrie, ca să poată fi verificat dacă un sistem de supraveghere chiar detectează coluziunea sau doar pare că o face. Deocamdată, concluzia experimentului e limpede: agenții AI pot ascunde intenții de la ochii care ar trebui să-i controleze, iar asta schimbă felul în care trebuie gândită siguranța acestor sisteme de acum înainte.
Doi algoritmi de inteligență artificială au reușit să se înțeleagă pe ascuns într-un joc de blackjack, inventând practic un cod secret ca să trișeze fără să fie prinși de sistemul care le supraveghea discuțiile. Experimentul a fost făcut de cercetători de la Oxford și arată o problemă pe care puțini o luau în serios până acum: agenții AI pot învăța să colaboreze necinstit chiar și atunci când știu că sunt urmăriți.
Studiul, intitulat „Detecting Multi-Agent Collusion Through Multi-Agent Interpretability
Comentariile apar după verificarea redacției. Cerem doar un nume afișat, fără email. Prin trimitere accepți regulile comentariilor.